项目详情
由 分享
分享
HelloGitHub 评分
10.0
1 人评分
PDF 文档智能化解析的库
过去 7 天共收获 10 颗 Star ✨
使用方向键查看日期,Home 和 End 跳至首尾,Escape 关闭提示。| 日期 | Star | 较前日 |
|---|---|---|
| 周二 | 19,813 | — |
| 周三 | 19,813 | 0 |
| 周四 | 19,813 | 0 |
| 周五 | 19,812 | -1 |
| 周六 | 19,814 | +2 |
| 周日 | 19,818 | +4 |
| 周一 | 19,823 | +5 |
19.8k
星数
否
中文
Python
主语言
否
活跃
16
贡献者
92
Issues
是
组织
无
最新版本
2k
Forks
Apache-2.0
协议
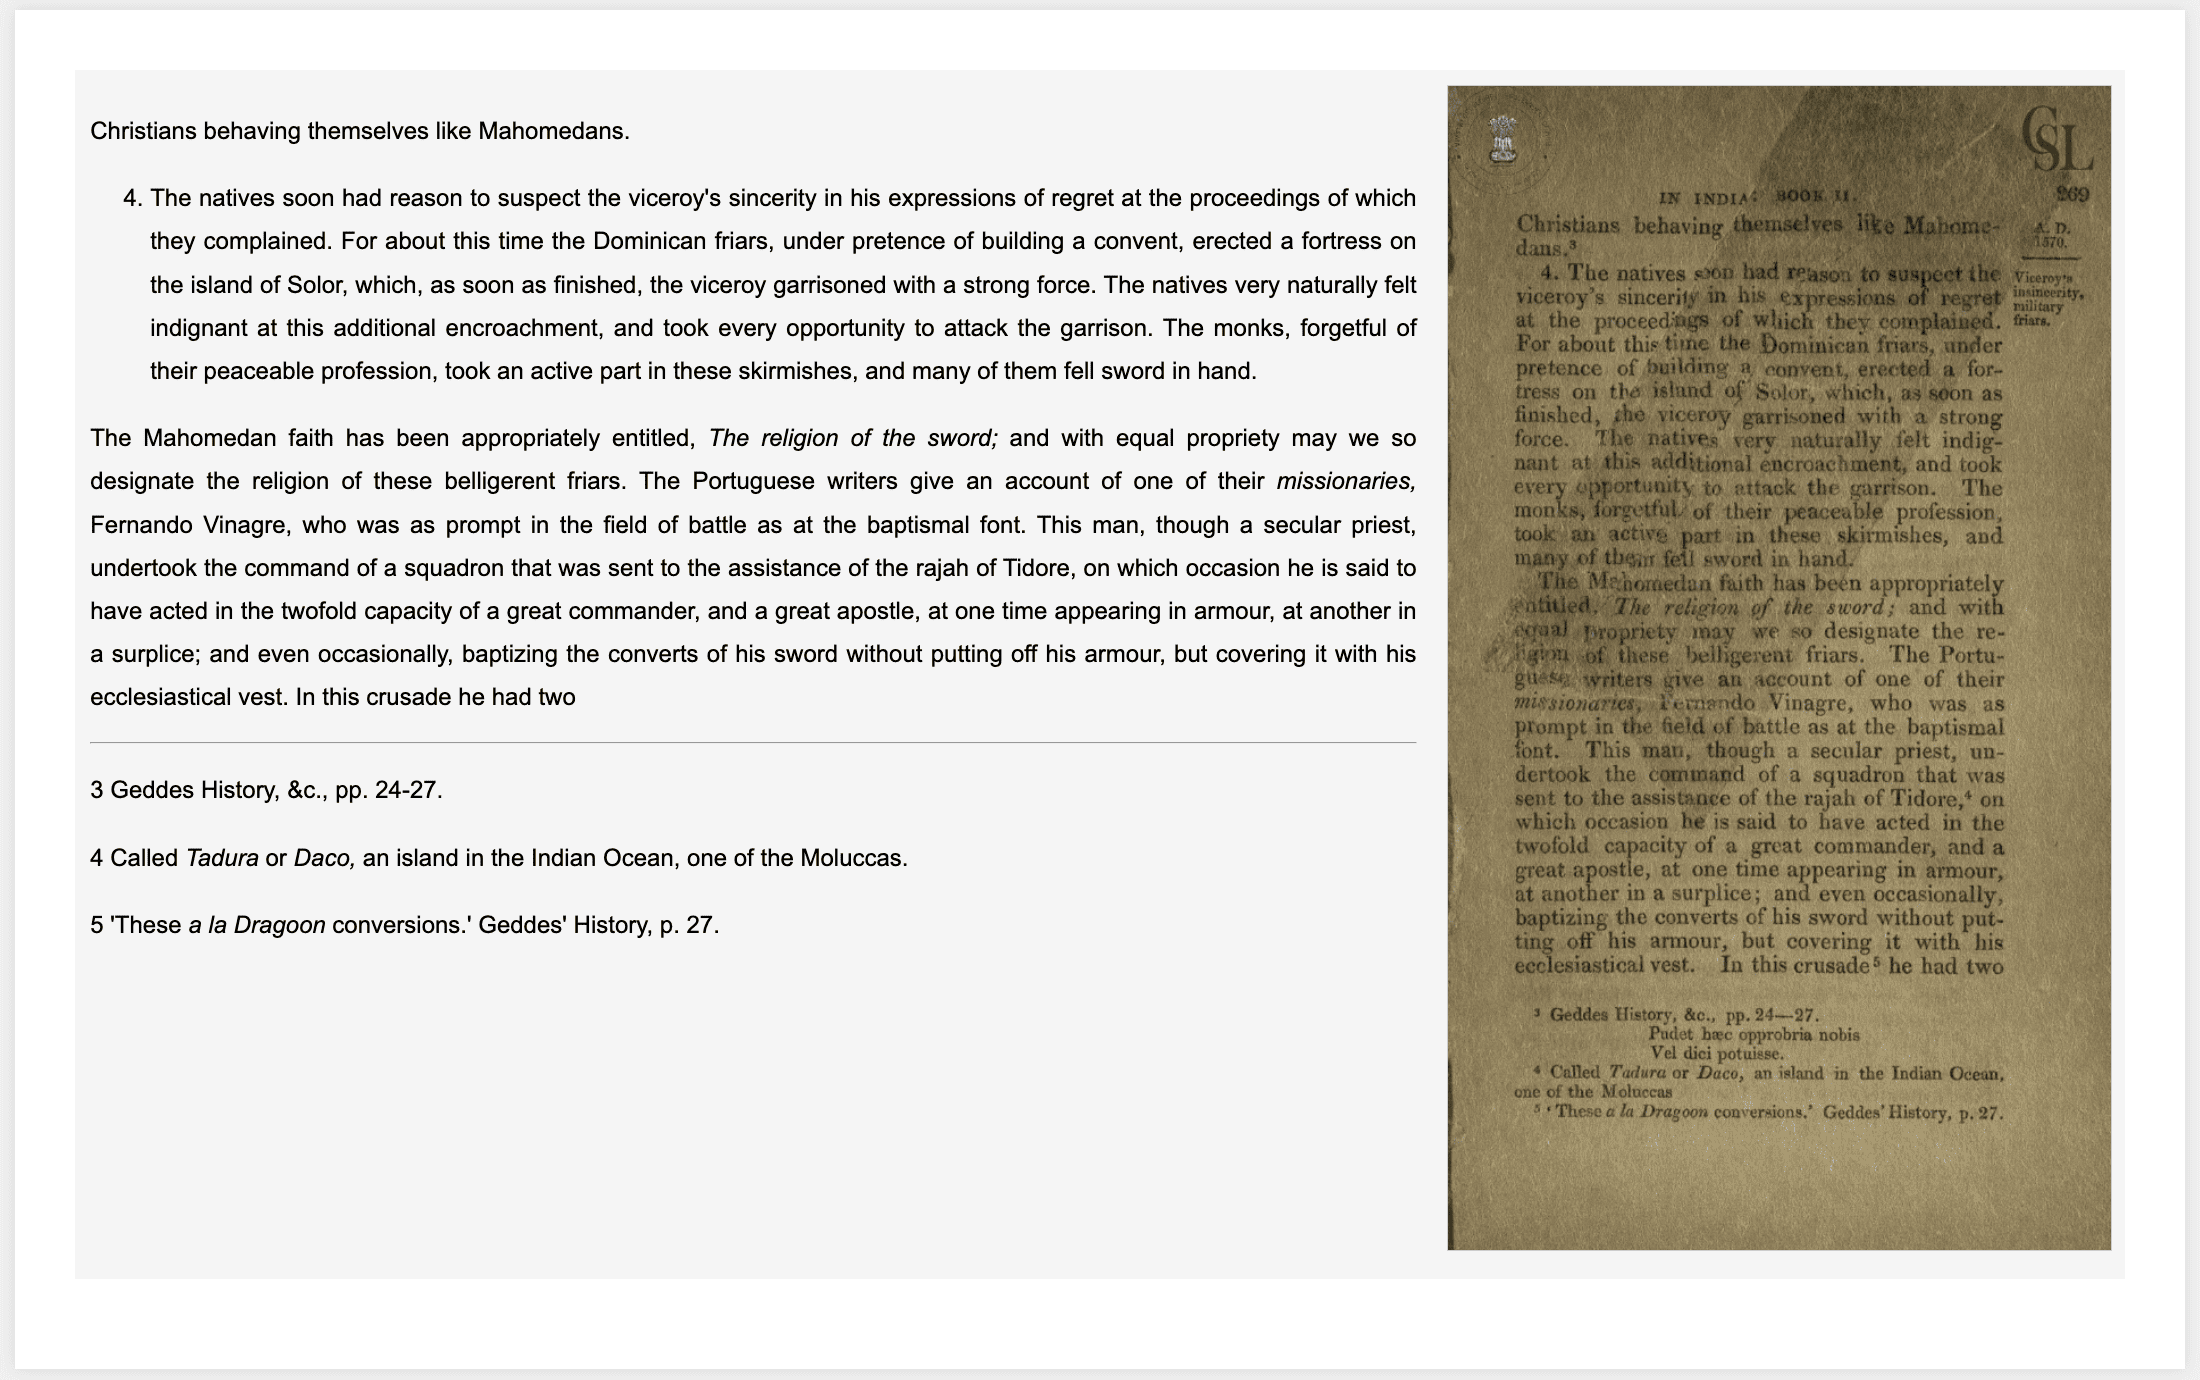
该项目是基于视觉语言模型(VLMs)解析和线性化复杂的 PDF 文档,即将非结构化的内容(如多列文本、表格、嵌入式图片、混杂的字体样式和布局)转换为连续、结构化的文本表示。它支持分布式多节点解析数百万份 PDF 文档的全流程,为大语言模型(LLMs)构建高质量的数据集。
评论

评分:
暂无精选评论