项目详情
由 分享
分享
HelloGitHub 评分
0 人评分
基于大模型的智能文本提取库
过去 7 天共收获 33 颗 Star ✨
使用方向键查看日期,Home 和 End 跳至首尾,Escape 关闭提示。| 日期 | Star | 较前日 |
|---|---|---|
| 周二 | 39,262 | — |
| 周三 | 39,266 | +4 |
| 周四 | 39,273 | +7 |
| 周五 | 39,275 | +2 |
| 周六 | 39,278 | +3 |
| 周日 | 39,285 | +7 |
| 周一 | 39,295 | +10 |
39.3k
星数
否
中文
Python
主语言
是
活跃
32
贡献者
119
Issues
是
组织
无
最新版本
3k
Forks
Apache-2.0
协议
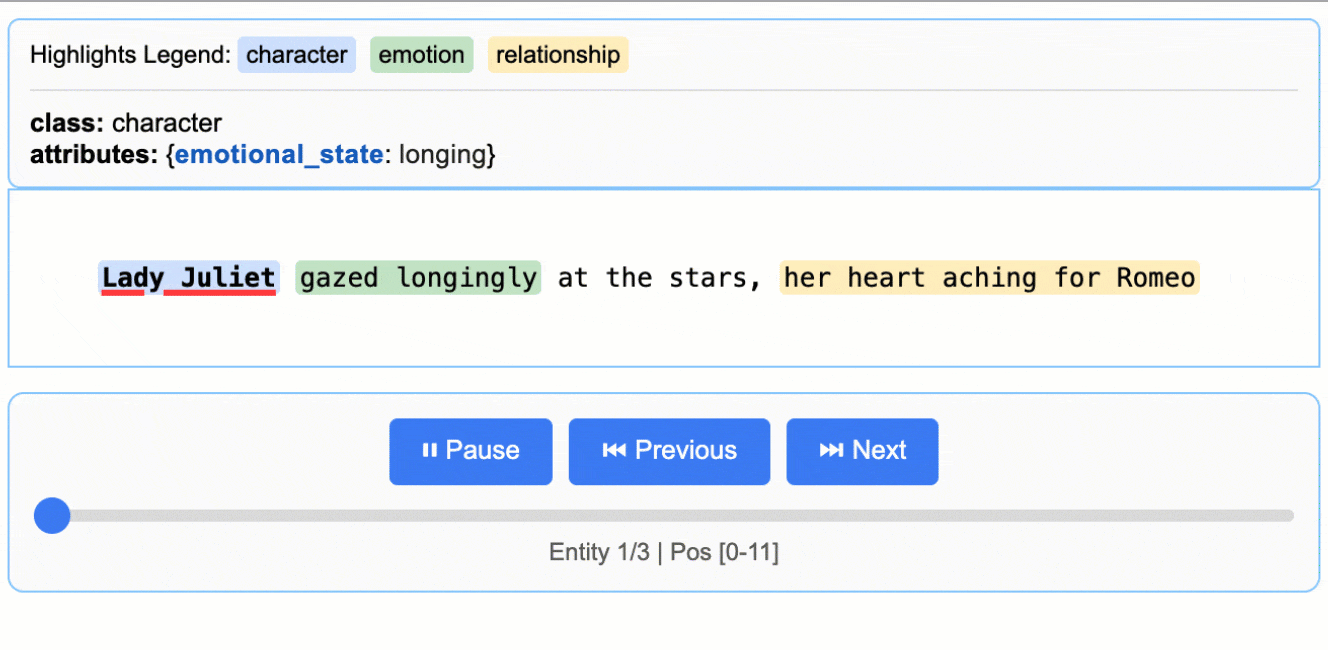
这是一款由 Google 开源的 Python 库,可实现自动识别和提取文本内容。它内置源文本的精确定位与交互式可视化功能。用户只需提供简短提示和少量示例,便可借助大型语言模型(如 Gemini)从非结构化文本中高效、精准地提取结构化信息。
评论

评分:
暂无精选评论